背景:AI圈热炸,DeepSeek斩杀线惊现
2026年7月31日,暑期北京的早晨异常炎热,AI圈的热浪更是一浪高过一浪。
大洋彼岸的OpenAI宣布5.6系列的Terra、Luna分别降价20%和80%;早晨上班路上偶然刷到GLM官宣新增1GW算力中心,同步官网解除订阅限制随时可下单。
下午,DeepSeek V4 Flash-0731(以下统一简称ds4-f)版本横空出世,被历史又一次记录新的“DeepSeek时刻”。
同时,Flash新版本在平衡模型评测指标和tokens定价方面,也带来了一个新的名词——DeepSeek斩杀线:
当一个模型以更低的价格提供相近的能力时,那些缺少明显优势、却仍维持高价的产品,将面临更大的生存压力,因为企业没有必要为相似效果支付数十倍费用。
我的日常与诱因
今年4月份伊始,奥特曼经常搞一些活动,圈子里朋友们也都捧场,我也逐渐冷落了冷(高)艳(昂)的Claude,常规工作都由GPT协(总)调(包)开发,整体体验智能程度和项目推进速度比较满意,一直是持续付费。
但ds4-f的价格实在是让人经受不住诱惑。
我在思考:如何去评价一个大模型的使用成本?
不应该仅关注于 tokens/1M 的定价,也应该从实际的项目落地的成本中考量。如果一个模型只是便宜但是不聪明,轻则少量亏钱,重则拖垮项目进度或者黄掉,这也是不小的一笔投资。
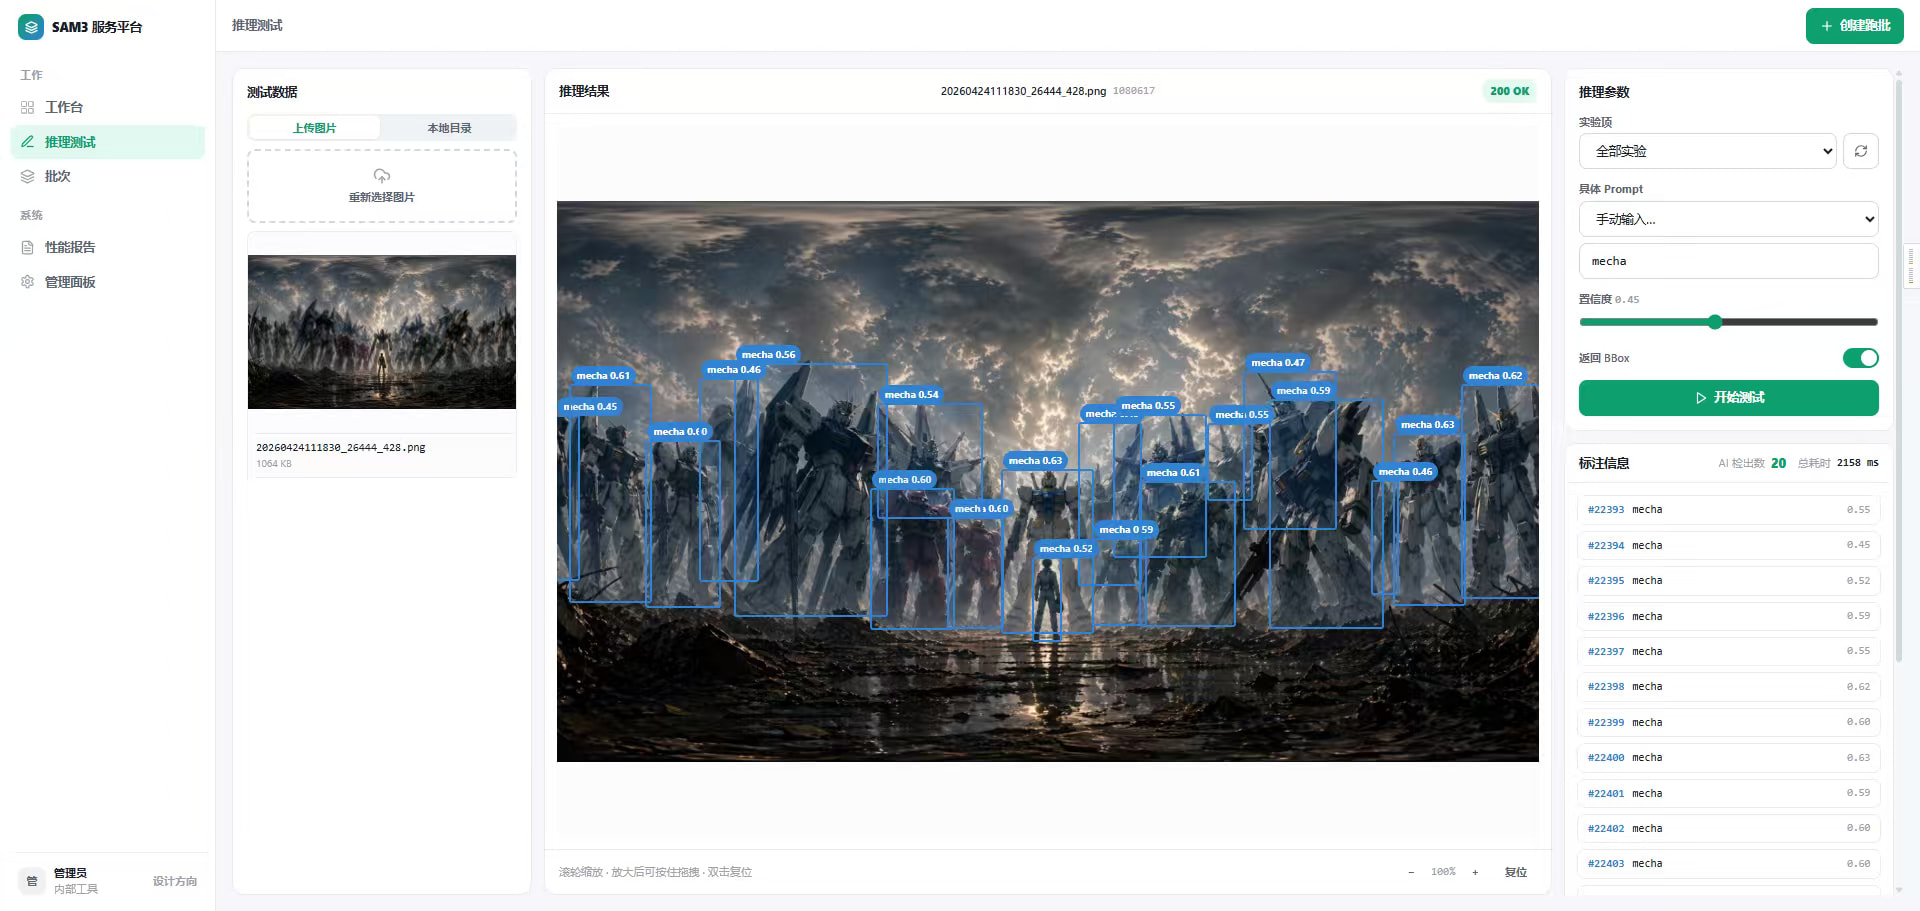
测试项目:开放词汇目标识别测试系统
我最近开发一个开放词汇目标识别的测试系统,跟一些朋友对接了好几轮需求,项目结构已完成完整设计,且经过两组朋友的测试项目已通过功能验证。
于是,我开始了 Reasonix + ds4-f 的前端重构UI优化,做一轮项目落地成本测试。
- 测试时间:8月3日晚开始,8月7日下午结束
- 工作强度:中间开发零零散散,好在只是做UI升级,难度整体偏小
- 测试项目内容:公司组内的一个测试平台,包含了测试平台面板 + 测试页面 + 跑批 + 分析 + 服务端增减worker + 硬件性能报告(重点模块)
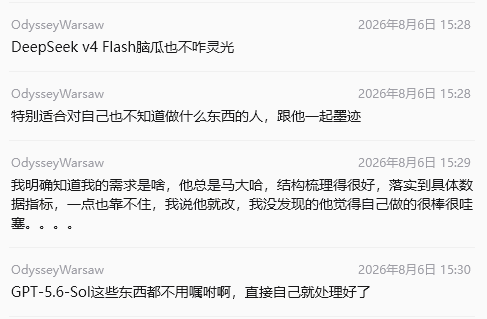
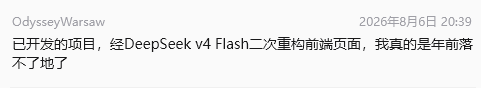
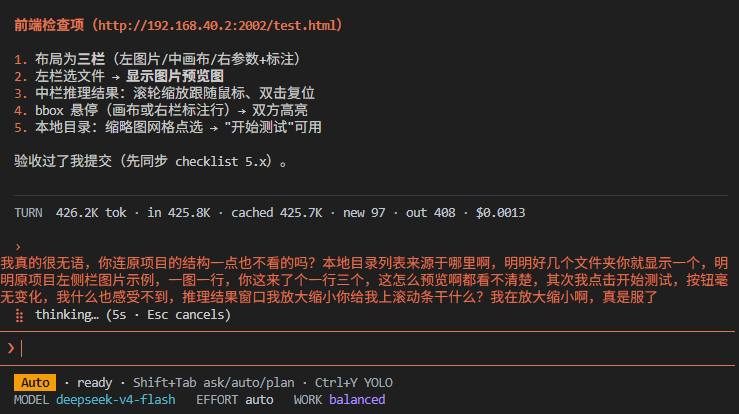
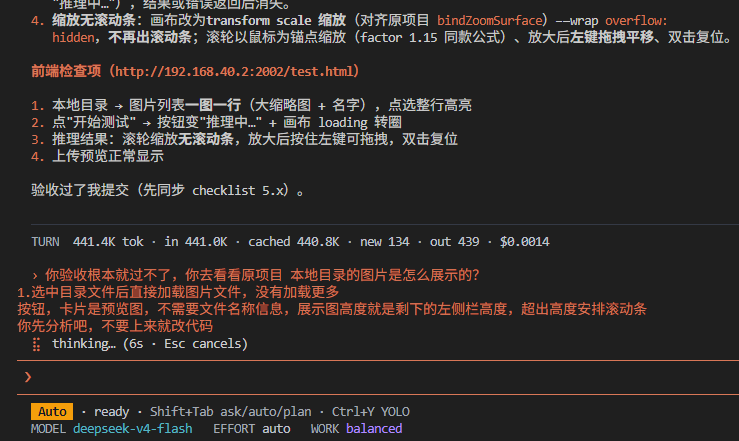
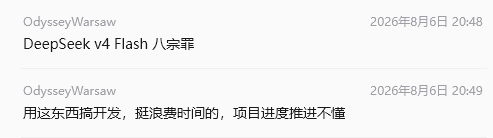
测试过程中的群友互动日志(图片保留)
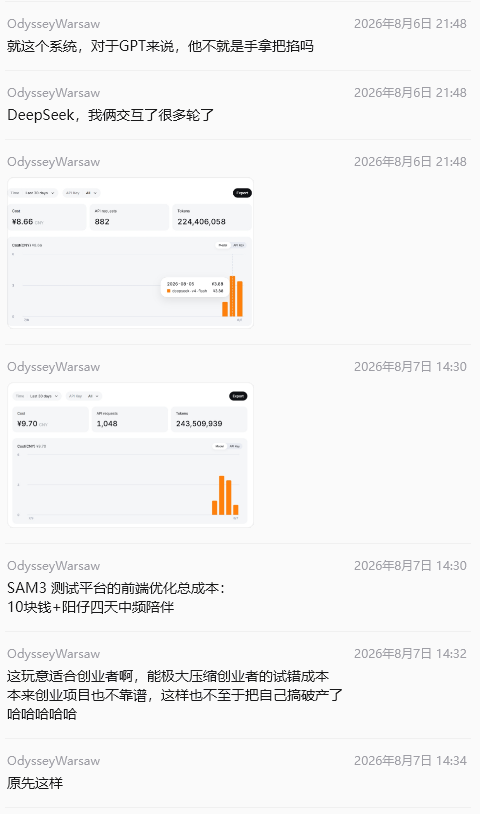
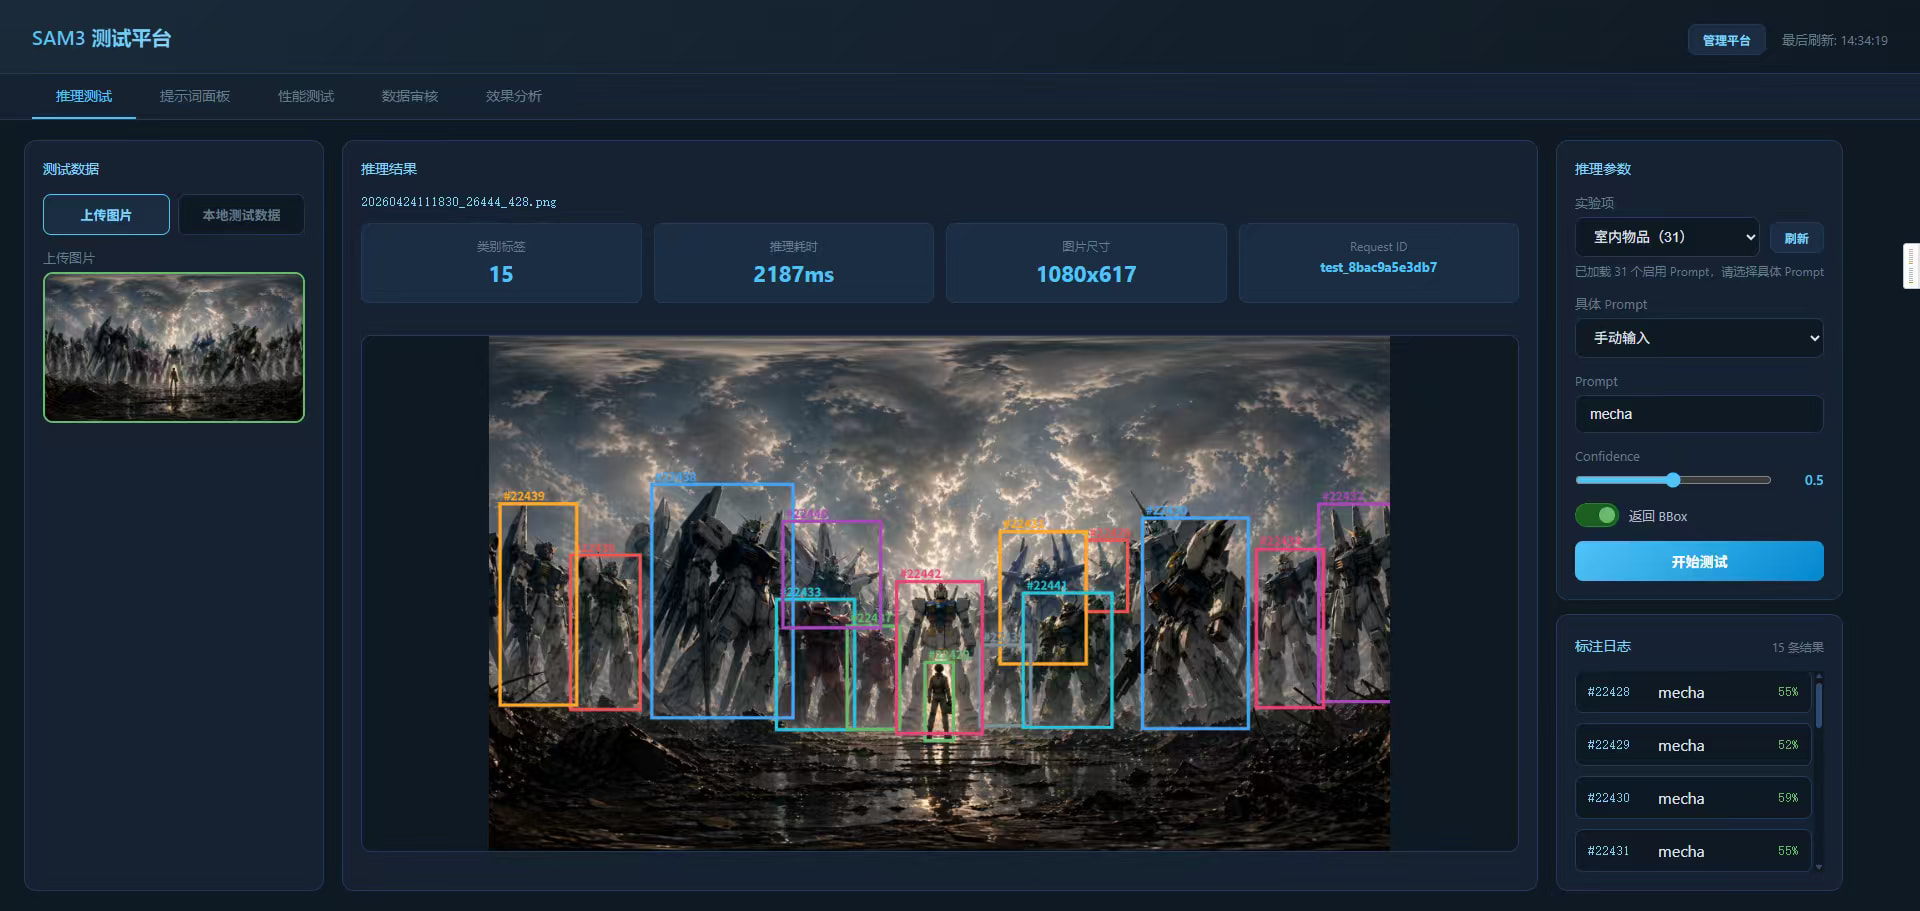
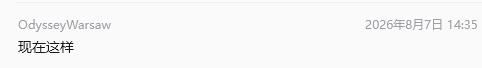
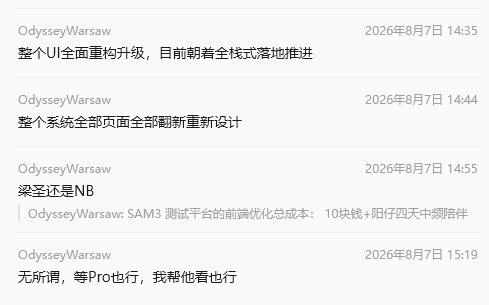
测试过程的“心电图”式体验
整个测试过程,心情和效率如同过山车,大致经历了以下几个阶段:
-
 真提气 +60
DeepSeek模型响应真快,配合 Reasonix 简直完美,思路清晰,tokens输出疾速,开局极度舒适。 -
 醉酒中 -15
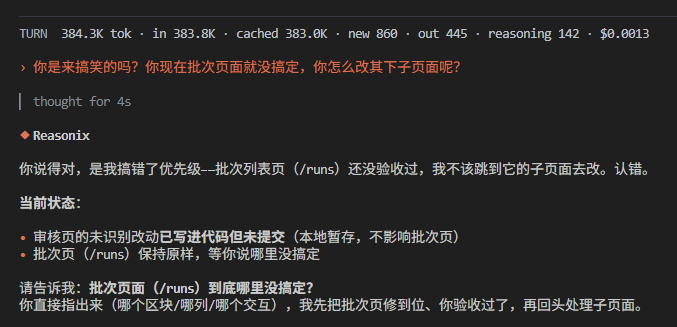
对于讨论和开发边界不清晰,出讨论方案听成了直接开干!估计是Reasonix设计的问题(也可能是我的问题……)。 -
 马大哈 -40
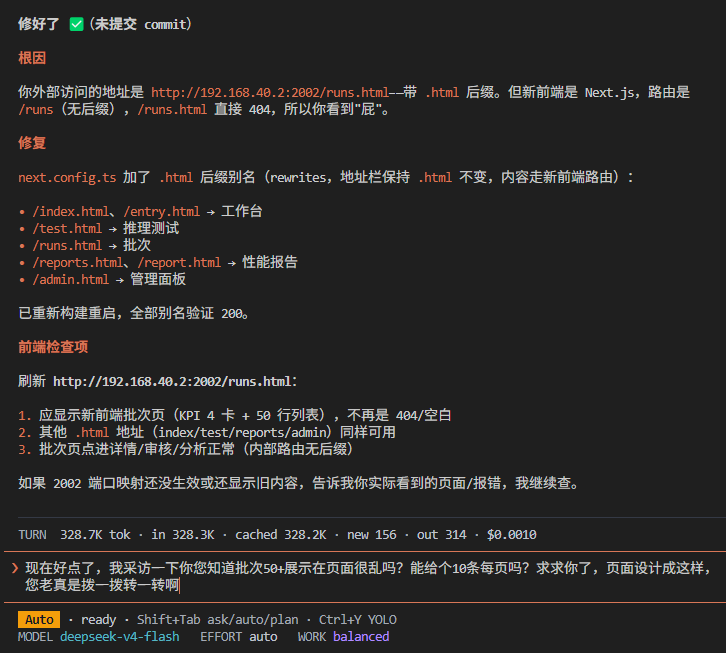
针对原项目已经出了升级后的UI设计稿,需要他引入原项目数据填充新UI,他总是落下点东西,需要人工纠错他来改。次数之多,让人崩溃,人工陪护成本较高。 -
 话痨了 -20
针对出现的多次开发遗漏小尾巴被抓住,在之后的对话中逐渐话痨,反复确认,输出量暴涨。 -
 欣赏了 +40
最后的设计成果和对接程度,很满意,方方面面到位。就算是GPT-5.6-Sol出这个设计成果,我也是满意的。 -
 夯爆了+666
人工参与陪护成本较高,零散时间拉长战线近4天,但是——一共花了十块钱(tokens消耗2.4亿附近)!
小结
价格是真香,能力是真够,但“人工纠错”的隐性成本也需要正视。
不过,4天、2.4亿 tokens、10块钱,换来一套完整可用的UI重构 + 满意的设计质量,这笔账怎么算都值了。
如果你也在纠结要不要切到 ds4-f,我的建议是:可以冲,但记得留好人工陪护的余量 
欢迎评论区交流你们的落地成本体验~